Entre promessas e ameaças: percepções públicas entre o medo do colapso e os mitos da inteligência artificial
Entre promesas y amenazas: percepciones públicas entre el miedo al colapso y los mitos de la inteligencia artificial
Between promises and threats: public perceptions between the fear of collapse and the myths of artificial intelligence
Ja’akapüna jümajalayaa pütchi jee omomolojoo: jünanajialu’u apashii ja’akapüna kamüse’ewaa juulialu’u yüütaa jee jukua’ipanayaa tü inteligencia artificial munaka
Resumo
Este artigo analisa como a percepção social da inteligência artificial, enquanto ameaça ou promessa, é construída na conversação pública digital. O problema investigado diz respeito à forma como conteúdos jornalísticos de ampla circulação ativam enquadramentos interpretativos associados ao trabalho, à desigualdade e ao futuro econômico. Metodologicamente, adota-se uma abordagem de social listening, baseada na mineração de dados de comentários publicados em uma plataforma de vídeo. O método combina extração automatizada e reprodutível dos dados com análise textual assistida pelo IRaMuTeQ, por meio de nuvem de palavras, análise de similitude, classificação hierárquica descendente e análise fatorial de correspondências. Os resultados indicam que a inteligência artificial é predominantemente codificada como uma ameaça à sobrevivência material, organizada em duas gramáticas discursivas centrais, colapso e redistribuição, cuja ativação varia conforme o enquadramento midiático. Conclui-se que a conversação pública opera como um termômetro discursivo de uma transição tecnológica percebida como rápida, assimétrica e socialmente arriscada.
Palavras-chave: análise do discurso, emprego, inteligência artificial, mineração de dados.
Resumen
Este artículo analiza cómo-se construye socialmente la percepción de la inteligencia artificial como amenaza o promesa en la conversación pública digital. El problema abordado es la forma en que contenidos periodísticos de alta circulación activan marcos interpretativos ligados al trabajo, la desigualdad y el futuro económico. Metodológicamente, se adopta un enfoque de social listening basado en minería de datos de comentarios publicados en una plataforma de video. El método combina extracción automatizada reproducible y análisis textual asistido por IRaMuTeQ, utilizando nube de palabras, análisis de similitud, clasificación jerárquica descendente y análisis factorial de correspondencias. Los resultados muestran que la inteligencia artificial es codificada predominantemente como una amenaza a la supervivencia material, organizada en dos gramáticas discursivas principales, colapso y redistribución, que varían según el encuadre mediático se concluye que la conversación pública funciona como un termómetro discursivo de una transición tecnológica percibida como rápida, asimétrica y socialmente riesgosa.
Palabras clave: análisis del discurso, empleo, inteligencia artificial, minería de datos.
Abstract
This article examines how public digital conversation constructs artificial intelligence as either a threat or a promise. The problem addressed concerns how widely circulated journalistic content activates interpretive frames related to work, inequality, and economic futures. Methodologically, the study adopts a social listening approach based on social media data mining publicly available video comments. The method combines reproducible automated extraction with text analysis assisted by IRaMuTeQ, including word clouds, similarity analysis, descending hierarchical classification, and correspondence factor analysis. Results indicate that artificial intelligence is predominantly framed as a threat to material survival, structured around two main discursive grammars, collapse and redistribution, which vary according to media framing. The study concludes that public conversation operates as a discursive indicator of a technological transition perceived as rapid, asymmetric, and socially risky.
Keywords: discourse analysis, employment, artificial intelligence, data mining.
Jüküjia palitpütchiru’u
Karaloutakat asanaasü jamüin jukuamajia amünii junala’aya tü inteligencia artificial munaka maka jaa’in omomolojia otta jümajalayaa pütchi jünain a’younanii kachuweeralujutu apashii. Jupounuala ojupatunaka jiaja’a jamüin ji’ipapa’a jüküjeeka karaloutalu’u wattakuitka aküjain ashukajaka jünüikiyaa atumawaa jünainmüin a’yatawaa, tü alü’üjuwaakat jee aletseeinjatka watta ka’i. Jü’yataayapala, aapanüsü wanee ama’anaajana listening münüsü jüma’anajeejatü apatülii jüwashirüin mma jukua’ipamaajatü aküjüüshi a’walakajuushi’pa achiki julu’upüna ayolojoopi kaxhuweeralutu. Ju’unajiria epeipajaasü jünainjee apatía laülaasulu’u kachotulesü jee jüsanaalalu’u ashajuushi jaapajala kejeetsekat IRaMuTeQ, ojuupajakat jüpüla jü’yataala pütchi sirumatujutu, jüsanaaya pütchi meitaawasü akolochijiishi jukua’ipalu’u jupo’u iipünaamüinkuwolu jee jüsanaayamüin jüküjia wanaawalu’u. Ojuitaaka jünainjee e’iyatsü jiain tü inteligencia artificial münakat akuyamauushisü muloushaatalu’u maka jaa’in wanee amomolojia jümüin tü jainyoulekat korolo, julu’ujeejatka piamasü jeerü kanüikat palajana, yütajaa jee jupolojiraaya mainmatua, awanaja’awoika eepünaale juchuntaanüin maalü. Jaakajaayamüin tü aashajawaakat apashii okoyotsü maka jaa’in wanee kachuweera ayaawatülü tuttaa jümüin jünüikinjatüka kachuweera wajaachonlu’u, atüjaanaka a’u jiain kakuwain, pounuayaakat jee keewainseyuiwa namüin wayuwain.
Pütchi katsüinsükat: kapütchinsükat, yanamaa, inteligencia artificial münakat, ajapatükat washuraa mmapüjee.
Introdução
A ansiedade que hoje envolve a inteligência artificial não surge no vazio. Ela se insere em contextos nos quais a precariedade laboral já é uma experiência disseminada, com trajetórias marcadas por instabilidade, informalidade, baixos salários e uma sensação persistente de futuro incerto. Nesse terreno, a promessa de que a inteligência artificial resolverá problemas estruturais convive com uma suspeita cada vez mais explícita de que a mesma tecnologia pode acelerar a substituição do trabalho humano, degradar condições de trabalho e concentrar ainda mais o poder econômico. Relatórios recentes alertam que, sem políticas de transição, proteção social e reconversão, os benefícios podem-se distribuir de forma desigual e ampliar desigualdades já existentes (OECD, 2024; WEF, 2025).
No artigo clássico Doomsday Friday, 13 November, A.D. 2026, Von Foerster, Mora e Amiot sustentam que o limiar sugerido por seu modelo não deve ser lido como previsão apocalíptica, mas como indício de saturação social. Em uma passagem central, assinalam que “our great great grandchildren will not starve to death. They will be squeezed to death” (Von Foerster, Mora, & Amiot, 1960, p. 1295), isto é, que o horizonte problemático não é a fome, mas o esmagamento produzido pela densidade e pela pressão social. A preocupação central desloca-se, assim, da escassez material para a capacidade limitada dos arranjos sociais e institucionais de absorver dinâmicas de crescimento acelerado quando não existem mecanismos eficazes de regulação coletiva.
Esse enquadramento é pertinente para interpretar temores contemporâneos associados à inteligência artificial, porque desloca o olhar de uma ameaça estritamente técnica para efeitos sistêmicos sobre o trabalho, a coesão social e a estabilidade da ordem econômica. Nessa chave, o debate atual pode ser compreendido como uma discussão sobre resiliência institucional diante de processos de mudança rápida, com risco de precarização e erosão das bases materiais que sustentam a vida social e econômica.
Como adverte Geoffrey Hinton, um dos pioneiros da inteligência artificial, “estamos em um ponto da história em que está acontecendo algo extraordinário, e pode ser incrivelmente bom ou incrivelmente ruim, as coisas não vão continuar como estão” (Hinton, citado em Criddle, 2025). A afirmação sintetiza o clima de incerteza que atravessa a conversação pública contemporânea e que se intensifica quando a inteligência artificial é associada ao trabalho, ao emprego e à sobrevivência material.
Essa preocupação se amplifica quando circula em formatos de alta difusão, com linguagem acessível, no interior de plataformas de vídeo. Neste estudo, duas peças jornalísticas em língua portuguesa ativam marcos de percepção complementares. Uma pergunta-se a IA pode impulsionar uma ruptura do capitalismo ao tornar mais rentável investir em máquinas do que contratar pessoas. A outra apresenta um cenário distópico associado ao relatório AI 2027, narrando uma escalada acelerada de capacidades, efeitos sistêmicos e consequências extremas, incluindo a perda massiva de empregos ao longo da sequência narrativa. Em ambos os casos, as métricas públicas de visualização não são tratadas como indicador de veracidade, mas como sinal de circulação social e de centralidade temática no imaginário público digital (BBC News Brasil, 2025a, 2025b).
O aspecto decisivo é que um dos materiais analisados se articula em torno do relatório AI 2027 (Kokotajlo et al., 2025), o qual não opera apenas como alerta, nem somente como ficção prospectiva. Ele funciona, antes, como um molde narrativo que organiza medos já presentes ao propor marcos, limiares e uma temporalidade de aceleração, na qual o ser humano aparece potencialmente deslocado sob determinadas condições, especialmente quando a lógica tecnológica se subordina a dinâmicas de poder e à maximização de benefícios econômicos. O cenário introduz de forma explícita o conflito social vinculado ao emprego e descreve pressões políticas orientadas a conter a desordem resultante, incluindo propostas como a renda básica universal como mecanismo de estabilização. Esse arranjo entre automação, turbulência laboral e resposta política torna especialmente fértil a análise da recepção, porque a ameaça deixa de ser abstrata e se traduz em um roteiro de sobrevivência material socialmente reconhecível.
Este artigo não busca medir uma atitude simples de aprovação ou rejeição da tecnologia. O foco é compreender como se narra o futuro quando a vida depende de um salário e esse salário é percebido como estando em risco. Os comentários permitem observar temores concretos, como perder o emprego, não conseguir o primeiro, ficar preso a trabalhos mal remunerados, competir com sistemas automatizados, depender de plataformas e ver o consumo cair. Junto a esse plano material emerge uma leitura moral e política, que envolve disputas sobre quem decide a transição, quem se beneficia, quem assume os custos e que papel se atribui ao Estado, às empresas e aos meios de comunicação.
Essa aproximação se apoia em uma tradição de estudos de comunicação que entende a recepção como produção ativa de sentido, na qual mensagens são decodificadas a partir de posições sociais diferenciadas e geram leituras dominantes, negociadas ou em disputa (Hall, 1980). A teoria do enquadramento, por sua vez, permite analisar como o público define o problema, atribui causalidades e legitima soluções em disputa (Entman, 1993). Em ambientes conectivos, além disso, o debate-se organiza com forte dimensão emocional, que estrutura o público não como ruído, mas como componente do sentido e do pertencimento (Papacharissi, 2015).
Esse enfoque dialoga com evidências recentes sobre exposição ocupacional à automação e sobre a reconfiguração de tarefas pela IA generativa. A OIT refinou índices globais de exposição e sustenta que o efeito mais plausível não se reduz à substituição total, mas à recomposição de tarefas, com riscos de deslocamento e degradação quando não há políticas de transição e proteção social (Gmyrek et al., 2025). A cobertura internacional de estudos regionais também alerta que a combinação entre desigualdade estrutural e informalidade laboral pode agravar efeitos distributivos da automação, mesmo quando o impacto da inteligência artificial é parcial e não implica substituição completa do trabalho humano (Reuters, 2024).
O relatório AI 2027 também ativa uma camada cultural que ajuda a explicar a intensidade de certas respostas. A imaginação social de futuros distópicos, nos quais máquinas gerenciam sistemas vitais e deslocam humanos, não é nova. Ela compõe um arquivo narrativo amplamente compartilhado. Figuras como HAL 9000, em 2001 A Space Odyssey, em que o computador prioriza sua própria sobrevivência diante da tripulação humana, e Skynet, em Terminator, frequentemente associada na crítica cultural à tradição inaugurada por narrativas como Second Variety, de Philip K. Dick, condensam o temor da delegação total, da opacidade das decisões automatizadas e da inversão moral do cuidado, quando o técnico deixa de proteger o humano. Em chave distinta, mas convergente, Golem XIV, de Stanislaw Lem, simboliza a assimetria radical entre inteligência humana e não humana ao apresentar uma entidade voltada a um conhecimento transcendental próprio, desligado de interesses, valores e necessidades humanas, com implicações profundas para dignidade, agência e sentido. Essa memória cultural atua como um imaginário sociotécnico que não apenas antecipa futuros possíveis, mas também orienta a interpretação coletiva do risco, oferecendo marcos narrativos compartilhados por meio dos quais a ameaça tecnológica pode ser reconhecida, avaliada e discutida publicamente (Jasanoff & Kim, 2015; Kirby, 2010; Kubrick, 1968; Lem, 1981; Dick, 1953).
A partir desse ponto, o objetivo é formulado de modo direto. Busca-se analisar, por meio do corpus de comentários gerados por esses dois vídeos, como se constroem socialmente marcos de ameaça e de promessa em torno da IA, quais emoções dominam, quais repertórios morais emergem e quais horizontes de futuro se tornam imagináveis quando trabalho e sobrevivência material ocupam o centro da discussão. Do ponto de vista metodológico, o artigo combina uma leitura comunicacional de recepção e enquadramento com análise textual assistida por software, utilizando o IRaMuTeQ para identificar regularidades lexicais, classes discursivas e estruturas de sentido capazes de descrever, com base empírica, a conversação pública digital gerada por ambos os enquadramentos (Camargo & Justo, 2013; Ratinaud, 2009).
O trabalho adota ainda uma abordagem de social listening para examinar comentários como rastros nativos das plataformas, os quais permitem observar a construção coletiva de significados em torno de temas diversos, aqui, a inteligência artificial. Mais do que medir opiniões individuais, o social listening busca identificar marcos interpretativos, repertórios culturais e climas afetivos que estruturam a conversação pública em ambientes digitais (Rogers, 2013; Papacharissi, 2015). Nessa perspectiva, os comentários funcionam como um observatório empírico dos imaginários sociotécnicos por meio dos quais a sociedade processa tecnologias emergentes, especialmente quando elas são percebidas como ameaça ao trabalho e à sobrevivência material (Jasanoff & Kim, 2015).
Este estudo tem como objetivo descrever e comparar marcos discursivos de promessa e de ameaça associados à inteligência artificial na conversação pública digital, a partir de comentários publicados no YouTube em reação a duas peças jornalísticas. A investigação é orientada por duas perguntas de pesquisa. Em primeiro lugar, quais repertórios temáticos e afetivos dominam em cada vídeo. Em segundo lugar, quais diferenças estruturais se observam entre os dois conjuntos de comentários, em termos de classes lexicais e de associações semânticas.
Marco teórico
Analisar comentários no YouTube para compreender percepções sociais sobre inteligência artificial e trabalho apoia-se com solidez numa tradição comunicacional que entende a recepção como um processo ativo de produção de sentido. A partir da proposta de Stuart Hall, as mensagens mediáticas não circulam como significados fechados, mas como ofertas interpretativas que as audiências negociam a partir de experiências, posições e quadros culturais diferenciados. Essa negociação manifesta-se em leituras dominantes, negociadas ou posicionadas. No ecossistema das plataformas, tal processo torna-se parcialmente observável por meio da escrita pública dos comentários, em que o conteúdo deixa de ser um objeto consumido em silêncio e passa a constituir interação, disputa simbólica e arquivo de interpretações em curso. Hall (1980) permite, assim, situar o corpus como um registo situado de recepção, e não como mera reação espontânea.
Esta perspectiva ganha poder explicativo quando articulada com a teoria do enquadramento tal como formulada por Entman. Nesta abordagem, os enquadramentos organizam a percepção pública ao definir o que conta como problema, a quem se atribuem causas, que juízos morais são ativados e que respostas se imaginam como legítimas. Entman (1993) ajuda a passar de fragmentos isolados a uma descrição sistemática de estruturas de sentido que ordenam a percepção do trabalho diante da inteligência artificial. Em conteúdos sobre inteligência artificial, o próprio dispositivo audiovisual tende a propor um enquadramento inicial por meio do título, do tom e da seleção narrativa. A discussão nos comentários reconfigura esse ponto de partida, desloca o foco ou intensifica certos elementos. Desse modo podem emergir padrões interpretativos relativamente estáveis, como a substituição laboral lida como injustiça, a automação como punição, a inevitabilidade técnica como destino social ou a educação como saída moralmente preferível.
A problemática também se inscreve em diagnósticos recentes sobre cenários de transformação do trabalho. O World Economic Forum (WEF) adverte que trajetórias de aceleração tecnológica sem mecanismos robustos de educação e requalificação podem ampliar desigualdades, com impactos relevantes em economias emergentes. Nessa linha, o relatório enfatiza a importância de políticas de formação digital e de emprego inclusivo como condições de resiliência social. WEF (2025) oferece, portanto, um pano de fundo útil para contextualizar porque debates sobre trabalho e inteligência artificial tendem a ativar repertórios de risco, justiça e futuro.
Ao mesmo tempo, a conversa pública digital configura-se de modo inseparável de uma dimensão afetiva. Papacharissi propõe compreender esses ambientes como espaços de públicos afetivos, nos quais a emoção não é um resíduo do debate, mas um componente que organiza a atenção, a pertença e a própria forma do público. Papacharissi (2015) permite ler os comentários como marcas de climas morais e emocionais que acompanham a interpretação de uma mudança percebida como iminente. Em discussões sobre trabalho, essa dimensão tende a expressar-se por ansiedade diante da precarização, raiva face a assimetrias de poder, ironia como defesa, resignação como estratégia de enfrentamento e esperança tecnoutópica como promessa de resgate. Com cautela analítica, tais afetos podem operar como indicadores culturais situados. Não representam estatisticamente uma população inteira, mas condensam estados sociais que se tornam visíveis na arena pública digital.
Para que essa leitura seja defensável, a análise deve ser situada na lógica das plataformas. Van Dijck, Poell e de Waal argumentam que vivemos numa sociedade de plataformas em que infraestruturas privadas medeiam de forma central a vida pública, reordenando valores, visibilidade e formas de participação. Van Dijck et al. (2018) permitem tratar o comentário como prática produzida sob condições de interface, moderação e incentivos de interação. Em chave econômica, Srnicek descreve o capitalismo de plataformas como um modelo de acumulação baseado em infraestruturas digitais e extração de dados, com efeitos diretos sobre a reorganização do trabalho e sobre novas dependências sociotécnicas. Srnicek (2016) contribui para ancorar o debate em relações materiais de poder, para além de interpretações estritamente culturais.
Neste quadro, torna-se particularmente útil a proposta de Gillespie, para quem os algoritmos devem ser entendidos como mediadores culturais que organizam relevância e hierarquizam conteúdos, influenciando a conversa pública. Gillespie (2014) ajuda a compreender que o corpus não é um espelho neutro, mas um produto situado de regras de visibilidade e de atenção. Este ponto ganha densidade adicional quando o objeto debatido é a própria inteligência artificial. O espaço em que se discute automação é, simultaneamente, um ambiente automatizado que ordena visibilidade e atenção. Essa dupla condição orienta a interpretação de narrativas recorrentes sobre controlo, manipulação ou futuro imposto, não como fatos já demonstrados pelo corpus, mas como expectativas analíticas plausíveis que precisam ser verificadas por evidência textual.
A economia política dos dados permite aprofundar essas percepções em termos de relações de poder. Zuboff conceitua o capitalismo de vigilância como uma forma de acumulação que captura e monetiza informação comportamental, reconfigurando assimetrias de autonomia e autoridade na vida cotidiana. Zuboff (2019) fornece um marco para compreender por que a ameaça percebida sobre o trabalho frequentemente se amplia para inquietações sobre perda de controlo, concentração de poder e sensação de futuro decidido sem deliberação pública. Couldry e Mejias, a partir da noção de colonialismo de dados, interpretam a extração sistemática da vida social como recurso, naturalizando apropriações e reproduzindo desigualdades. Couldry e Mejias (2019) reforçam, assim, a ideia de que a percepção social não se reduz a emprego ou desemprego, mas envolve dignidade, valor humano e justiça distributiva.
Do ponto de vista metodológico, a legitimidade de trabalhar com comentários como insumo empírico sustenta-se na literatura de métodos digitais e na crítica à ilusão de representatividade automática. Boyd e Crawford advertem que dados massivos não são neutros e são produzidos no interior de infraestruturas com vieses de captura, participação e visibilidade, razão pela qual a pesquisa deve explicitar limites para evitar inferências indevidas. Boyd e Crawford (2012) orientam a delimitar com precisão o que pode e o que não pode ser afirmado a partir do corpus. Kitchin sublinha que a chamada revolução dos dados é atravessada por novas infraestruturas e formas de poder, e que o rigor depende de descrever como o dado é construído e que mediações o atravessam. Kitchin (2014) reforça a necessidade de transparência metodológica. Rogers, no âmbito dos métodos digitais, propõe que objetos nativos da web podem ser utilizados como material empírico com procedimentos replicáveis, desde que não se confundam rastros com totalidade social. Rogers (2013) permite sustentar o uso de comentários como indicador cultural situado, com delimitação clara do seu alcance.
Neste desenho, a análise textual com IRaMuTeQ mostra-se particularmente adequada para articular escala e leitura interpretativa. Camargo e Justo apresentam o IRaMuTeQ como um software que facilita a análise estatística do léxico, a classificação hierárquica descendente, a análise fatorial e a análise de similitude, permitindo identificar classes discursivas e redes semânticas em corpora extensos. Camargo e Justo (2013) oferecem a base metodológica para justificar sua utilização. Ratinaud destaca, além disso, a possibilidade de combinar procedimentos quantitativos com retorno ao texto por meio de segmentos característicos, favorecendo interpretações ancoradas em evidência textual e não apenas em frequências. Ratinaud (2009) permite sustentar uma estratégia de dupla leitura, primeiro a identificação de regularidades, oposições e co-ocorrências, e depois a interpretação contextualizada de segmentos representativos. Essa combinação ajuda a evitar tanto a leitura impressionista baseada em exemplos chamativos quanto a quantificação sem compreensão de sentido.
Metodologia
O estudo adota um desenho observacional e comparativo de métodos digitais, centrado em rastros nativos de plataforma. Neste caso, analisam-se comentários públicos associados a duas peças jornalísticas em vídeo, entendidos como produção situada de sentido e não como reflexo representativo da população geral. Essa escolha apoia-se na advertência de que dados massivos são produzidos por infraestruturas, vieses de participação e lógicas de visibilidade. Por isso, exigem explicitação metodológica para sustentar inferências prudentes (Boyd & Crawford, 2012; Kitchin, 2014; Rogers, 2013).
O corpus é composto por 3.692 comentários em língua portuguesa, extraídos de dois vídeos da BBC News Brasil publicados no YouTube. O primeiro vídeo (VID01, AI2027) corresponde ao conteúdo sobre o cenário AI2027, com 2.555 comentários, disponível em https://www.youtube.com/watch?v=oTptR7O0KNI (BBC News Brasil, 2025a). O segundo vídeo (VID02, FINCAP) corresponde ao conteúdo sobre a hipótese de ruptura do capitalismo, com 1.137 comentários, disponível em https://www.youtube.com/watch?v=gN9QAFG2A2w (BBC News Brasil, 2025b). A comparação entre ambos se justifica porque ativam enquadramentos distintos sobre um mesmo nó sociotécnico. De um lado, dramatiza-se a aceleração e o risco extremo. De outro, desloca-se a atenção para economia política, emprego, consumo e distribuição. Essa configuração permite observar variações em repertórios discursivos e afetivos sob estímulos midiáticos diferentes, mantendo constante o contexto nacional e a língua.
Os comentários foram coletados a partir de metadados e escrita pública acessível, por meio de um processo de extração automatizada e reprodutível realizado com scripts em Python. Registrou-se a data de captura, o identificador de cada vídeo e preservou-se o texto bruto. Com isso, garante-se a auditoria e a rastreabilidade de todo o processamento posterior.
Na fase de limpeza, aplicaram-se procedimentos padrão para corpora de interação. Realizou-se normalização de codificação, remoção de duplicados, supressão de links e marcas de tempo, bem como a eliminação de elementos não semânticos frequentes em comentários, por exemplo, risadas repetidas, interjeições mecânicas, marcas de usuário e resíduos de interface. Os emojis foram removidos quando interferiam na tokenização. A segmentação foi estruturada em dois subcorpora por vídeo, o que permite analisar convergências globais e diferenças internas segundo a condição de estímulo midiático.
A análise textual foi realizada com o IRaMuTeQ como ambiente de lexicometria e estatística textual, devido à sua capacidade de articular escala, classificação e retorno interpretativo ao corpus por meio de segmentos característicos e vocabulário associado. Essa estratégia permite evitar tanto interpretações intuitivas não sistematizadas quanto procedimentos estritamente quantitativos desconectados do sentido discursivo (Camargo & Justo, 2013; Ratinaud, 2009).
A análise restringe-se deliberadamente ao plano lexical dos comentários, excluindo elementos paralinguísticos como emojis e outros recursos gráficos, com o objetivo de identificar enquadramentos discursivos, regularidades semânticas e estruturas de sentido por meio de procedimentos lexicométricos reprodutíveis. Essa decisão se alinha a abordagens de métodos digitais que priorizam a rastreabilidade analítica e a comparabilidade entre corpora, evitando inferências opacas baseadas em sinais expressivos não padronizados (Rogers, 2013; Camargo & Justo, 2013).
Os dados originais, os corpora pré-processados e os scripts empregados estão disponíveis em um repositório aberto em GitHub, o que permite a replicação do estudo e sua extensão a outros contextos, plataformas ou debates sociotécnicos. Essa decisão se inscreve em princípios de ciência aberta e em advertências metodológicas sobre transparência e reutilização responsável de dados digitais (Boyd & Crawford, 2012; Kitchin, 2014).
O uso do IRaMuTeQ neste estudo apoia-se em experiências metodológicas prévias aplicadas à análise de comentários em ambientes digitais, nas quais a ferramenta demonstrou sua utilidade para identificar estruturas léxicas, núcleos semânticos e dinâmicas discursivas em corpus associados a acontecimentos midiáticos e políticos (Busón et al., 2022). Essa coerência metodológica é reforçada por antecedentes que articulam transformação tecnológica, percepção social e análise de rastros digitais, ao situar a inteligência artificial como um problema social e educativo que reorganiza expectativas e desigualdades. Nesse sentido, Busón et al. (2023) contribuem para consolidar esse enquadramento analítico. Do ponto de vista metodológico, a mineração de dados em redes sociais tem evidenciado que, por meio de procedimentos sistemáticos e rigor analítico, as plataformas podem operar como observatórios empíricos válidos para o estudo da construção social de sentido. Pérez Mendoza e Busón (2021) sustentam essa abordagem, desde que sejam explicitados os limites do corpus e as mediações de plataforma que condicionam sua produção.
O processamento geral do corpus produziu 2 textos, 2.700 segmentos de texto, 11.500 formas, 97.219 ocorrências e 7.399 lemas. A classificação alcançou 98,93% dos segmentos, com 4 classes na Classificação Hierárquica Descendente. Esse resultado sugere estabilidade interna adequada para uma interpretação comparativa de estruturas discursivas.
A estratégia foi organizada em quatro saídas complementares, cada uma com uma função analítica específica. Primeiro, a nuvem de palavras foi utilizada como exploração descritiva de saliência lexical. Sua função foi identificar núcleos temáticos dominantes e vocabulário de alta frequência, sem atribuir lhe, por si só, valor explicativo. Segundo a análise de similitude permitiu reconstruir co-ocorrências e redes semânticas, identificando centros de gravidade lexical, pontes entre campos e ramificações interpretativas. Esse procedimento é pertinente para observar como se articulam, em um mesmo espaço de conversação, tecnologia, trabalho, renda, humanidade e moralidade. Terceiro, a Classificação Hierárquica Descendente e sua projeção fatorial, com apoio da Análise Fatorial de Correspondências, foram empregadas para identificar classes discursivas, oposições estruturais e proximidades entre modalidades. Essas saídas operam como um mapa relacional do corpus, no qual cada classe pode ser interpretada como um repertório discursivo relativamente coerente, ancorado em vocabulário característico e em segmentos associados. Quarto, a análise de especificidades por subcorpus permitiu comparar, de modo controlado, quais termos se associam de forma diferencial a cada vídeo, consolidando uma leitura comparativa alinhada à hipótese de enquadramentos complementares, distopia escalonada versus economia política do trabalho.
O rigor foi sustentado por triangulação interna entre resultados, evitando depender de uma única visualização ou de uma única métrica. A interpretação apoiou-se na convergência entre classes, redes de similitude, posições fatoriais e especificidades, e ancorou-se em segmentos de texto característicos, a fim de manter retorno empírico ao discurso e não apenas à contagem lexical. Esse critério ajusta-se à lógica operativa do próprio IRaMuTeQ e a recomendações de métodos digitais para trabalhar com rastros sem confundi-los com totalidade social (Camargo & Justo, 2013; Rogers, 2013; Ratinaud, 2009).
Em termos éticos, trabalhou-se exclusivamente com comentários públicos, sem intervenção na conversação, e com apresentação de resultados em forma agregada, evitando exposição desnecessária de identificadores pessoais.
Resultados
Os resultados são apresentados a partir de quatro saídas complementares geradas no IRaMuTeQ, nuvem de palavras, análise de similitude, Classificação Hierárquica Descendente com sua projeção fatorial e análise de especificidades por subcorpus. A leitura conjunta permite descrever não apenas quais temas aparecem, mas como eles se organizam em repertórios de sentido, quais associações os sustentam e quais diferenças estruturais emergem entre VID01_FINCAP e VID02_ AI2027.
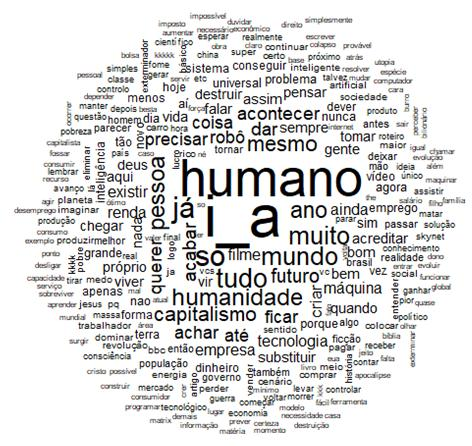
Figura 1. Nuvem de palavras, saliência lexical e hierarquias do debate.
Fonte: Dados dos documentos analisados no estudo de caso. Elaboração própria com apoio do IRaMuTeQ e do R.
A nuvem de palavras (figura 1) oferece uma primeira aproximação panorâmica à agenda discursiva do corpus. A alta saliência de termos como humano, ia, humanidade, mundo, futuro, tecnologia, robô, emprego, trabalho, capitalismo, empresa, renda indica que a conversação se estrutura por dois eixos simultâneos. Um eixo antropológico e moral, que situa a inteligência artificial em relação à condição humana, à continuidade do mundo social e à ideia de destino. E um eixo econômico material, que traduz o fenômeno em emprego, trabalho, empresa, salários, consumo e redistribuição.
A presença de léxico de futuro, por exemplo, futuro, ano, acontecer, em conjunto com verbos e construções associados a mudança ou ruptura, como destruir, virar, ficar, reforça que o debate não se coloca em chave de presente estabilizado, mas de antecipação. Em termos comunicacionais, isso sugere que os comentários operam como um espaço de prospectiva social cotidiana, no qual se negocia o que se torna imaginável como futuro e quais riscos são considerados plausíveis.
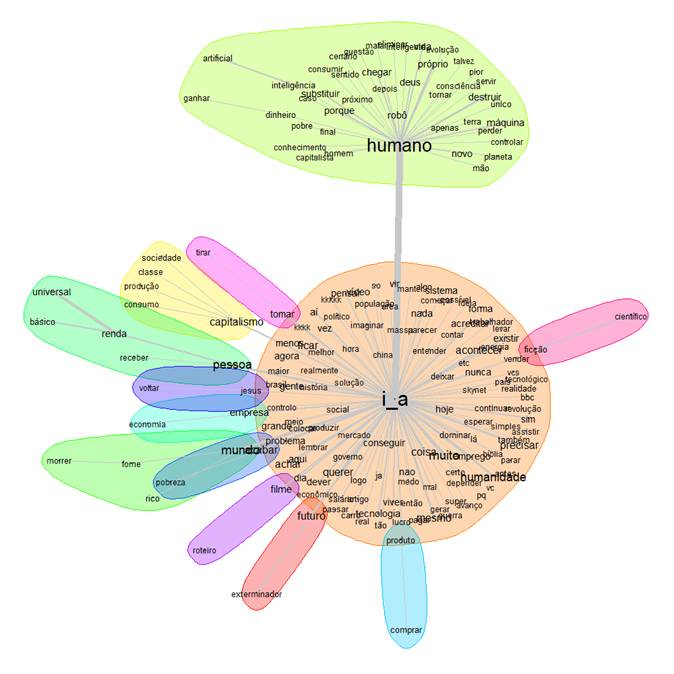
Figura 2. Análise de similitude, arquitetura relacional do significado.
Fonte: Dados dos documentos analisados no estudo de caso. Elaboração própria com apoio do IRaMuTeQ e do R.
Um traço adicional é a convivência entre vocabulário técnico e vocabulário cultural. Ao lado de tecnologia, robô e ia aparecem termos que remetem a traduções narrativas e culturais do risco, como filme, ficção, roteiro, bem como referências de figuração. Isso antecipa que parte da conversação não discute a inteligência artificial apenas como objeto técnico, mas como relato sobre controle, ameaça ou colapso, ancorado em repertórios culturais disponíveis.
Em conjunto, a nuvem de palavras não deve ser lida como simples contagem de frequências, mas como indicador de centralidade semântica. A dominância de humano e IA sugere que a automação é processada como conflito sobre agência, dignidade e continuidade social. Já a relevância de trabalho, emprego, empresa, renda e capitalismo indica que essa dimensão moral se materializa como problema distributivo e de sobrevivência cotidiana.
A análise de similitude (figura 2) permite passar da lista de palavras à estrutura de associações que organiza o sentido. O grafo se articula em torno de ia como nó central, a partir do qual se desdobram ramificações que formam polos semânticos diferenciados e relativamente estáveis.
Um primeiro polo, de caráter antropológico e existencial, organiza-se em torno de humano e conecta-se com termos como máquina, robô, consciência, destruir, planeta, controlar, dominar. Esse conjunto sugere um repertório no qual a inteligência artificial é interpretada como agente capaz de reconfigurar a ordem humana, com ênfase em autonomia, perda de controle e ameaça sistêmica. A relevância de consciência e controlar não é neutra. Ela indica que o público não discute apenas a automação de tarefas, mas a possibilidade de uma entidade que decide, administra infraestruturas e redefine prioridades, deslocando as pessoas de sua posição central.
Um segundo polo, de caráter econômico social, organiza-se ao redor de capitalismo e de suas conexões com empresa, trabalho, trabalhador, emprego, renda, consumo, dinheiro, comprar, pagar, classe, rico, pobre. Aqui, a inteligência artificial (IA) é traduzida como choque distributivo e crise do trabalho, com discussão explícita sobre continuidade do consumo, degradação de condições e possíveis respostas políticas. A presença de renda universal e de termos associados a consumo sugere que o debate é formulado como problema de reprodução social, isto é, como sustentar a vida quando o salário é percebido como ameaçado.
Um terceiro conjunto, de natureza cultural e interpretativa, aparece associado a termos como filme, roteiro, ficção e referências de cultura popular. Sua presença estrutural sugere que não opera como ornamento discursivo. Funciona como tecnologia interpretativa, pois permite tornar dizível o risco por meio de analogias, personagens e cenas já disponíveis culturalmente. Em outras palavras, parte do corpus processa a inteligência artificial através de narrativas prévias de automação, controle e colapso, o que contribui para a circulação de enquadramentos afetivos, como medo, ironia ou resignação, e para a consolidação de juízos morais.
A leitura do grafo evidencia, portanto, um ponto chave para a interpretação. A conversação publica se organiza como sistema de associações entre inteligência artificial, condição humana, economia política do trabalho e repertórios culturais de ameaça. Essa organização permite sustentar que o corpus não se reduz a opiniões fragmentárias. Ele apresenta estruturas semânticas que podem ser descritas, comparadas e colocadas em relação com enquadramentos midiáticos distintos.
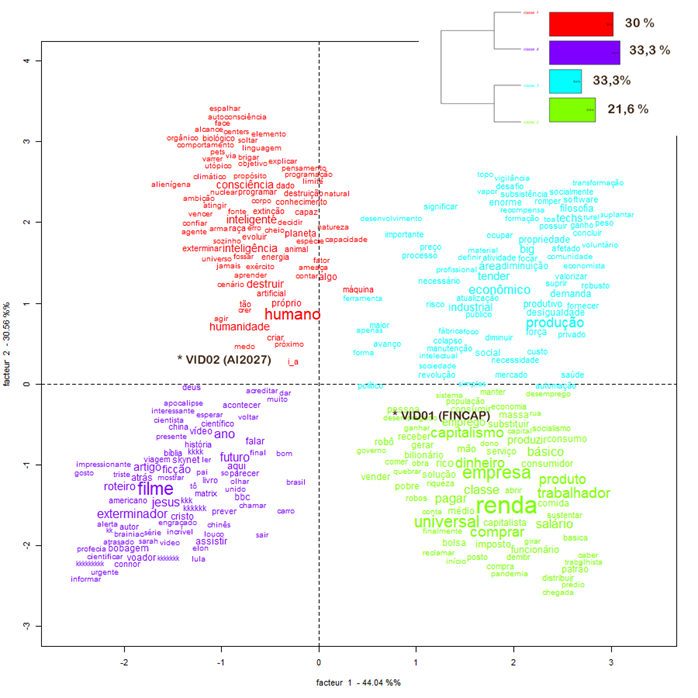
Figura 3. CHD e AFC, classes discursivas, percentuais e oposição entre VID01_FINCAP e VID02_ AI2027
Fonte: Dados dos documentos analisados no estudo de caso. Elaboração própria com apoio do IRaMuTeQ e do R.
A Classificação Hierárquica Descendente (figura 3), identifica quatro classes discursivas, com pesos diferenciados. O dendrograma indica a seguinte distribuição. Classe 4 com 33,3%, Classe 1 com 30,0%, Classe 2 com 21,6%, Classe 3 com 15,2%. Essa distribuição implica que o corpus se organiza em repertórios relativamente coerentes, com predominância de dois blocos principais, um cultural narrativo e outro existencial de ameaça, seguidos por dois blocos econômicos, um centrado em redistribuição e reprodução social e outro centrado em estrutura produtiva e economia política.
A projeção fatorial reforça essa organização e mostra uma separação clara entre os subcorpora. No plano, VID01_FINCAP localiza-se no lado positivo do Fator 1, enquanto VID02_ AI2027 localiza-se no lado negativo do Fator 1. O Fator 1 explica 44,04% da variação e o Fator 2 explica 30,56%. A separação associada ao Fator 1 sugere uma oposição estrutural vinculada aos enquadramentos midiáticos de partida. VID01_FINCAP aciona um marco econômico de ruptura da ordem produtiva e do consumo. VID02_ AI2027 aciona um marco prospectivo de escalada, perda de controle e colapso narrado.
A leitura por classes permite descrever com precisão quais repertórios sustentam essa oposição.
Classe 1, aproximadamente 30,0%, caracteriza-se por um repertório existencial, de ameaça e de agência não humana. Nessa classe agrupam-se termos vinculados a consciência, inteligente, capaz, destruir, exterminar, planeta, natureza, energia, arma, nuclear, medo, humano, humanidade, ia. Sua lógica semântica orienta-se para risco sistêmico, escalada, perda de controle e vulnerabilidade humana. Trata-se de uma classe que tende a moralizar a automação, não apenas como substituição de tarefas, mas como transformação da relação entre humanidade, técnica e sobrevivência.
Classe 2, aproximadamente 21,6%, organiza-se como repertório econômico distributivo e de vida material. Aparecem termos como renda, universal, básico, capitalismo, empresa, trabalho, trabalhador, salário, consumo, comprar, pagar, dinheiro, classe, rico, pobre, emprego, desempregado. O foco não é a autonomia técnica, mas o impacto sobre salários, emprego e reprodução social, com discussão de respostas políticas como renda universal e mecanismos de redistribuição. Essa classe articula preocupação com desigualdade e com quem assume o custo social da transição.
Classe 3, aproximadamente 15,2%, aproxima-se de um repertório econômico produtivo e de estrutura social. Associa-se a léxico como econômico, produção, industrial, mercado, custo, demanda, propriedade, desigualdade, privado, força, social, e a avaliações sobre processo e necessidade. Esse repertório tende a discutir mecanismos, produtividade, propriedade e modelos de organização econômica, com menor carga ficcional e maior orientação a diagnósticos estruturais.
Classe 4, aproximadamente 33,3%, reúne o repertório cultural e midiático de ficcionalização, referência popular e metadiscussão. Observam-se termos como filme, roteiro, ficção, exterminador, skynet, matrix, além de marcas ligadas ao consumo do conteúdo, vídeo, bbc, assistir, e referências religiosas como deus, jesus, bíblia, junto a expressões avaliativas. Essa classe funciona como laboratório de tradução cultural. O público processa a prospectiva como roteiro e mobiliza imaginários compartilhados para ordenar emoções, atribuir responsabilidades e dar forma narrativa a um risco técnico.
A combinação entre CHD e AFC sustenta um resultado central. A diferença entre VID01_FINCAP e VID02_ AI2027 não é superficial. Ela-se expressa em repertórios discursivos distintos e em sua separação no espaço fatorial. O subcorpus AI2027 tende a concentrar repertórios de ameaça existencial e tradução ficcional do risco. Já o subcorpus FINCAP se alinha mais a repertórios de economia política do trabalho e de redistribuição, com ênfase em renda, empresa, consumo e desigualdade. Essa estrutura é coerente com o fato de que AI2027 oferece uma narrativa prospectiva escalonada, enquanto FINCAP propõe um enquadramento econômico de ruptura do capitalismo por substituição do trabalho humano.
A análise de especificidades (figura 4) reforça e valida a leitura comparativa. Ao contrastar VID02_AI2027 e VID01_FINCAP, a visualização indica que as palavras não se distribuem do mesmo modo entre os subcorpora e que cada um aciona um léxico característico.
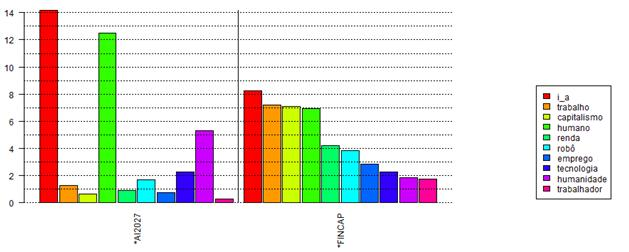
Figura 4. Análise de especificidades, traços diferenciais entre subcorpora.
Fonte: Dados dos documentos analisados no estudo de caso. Elaboração própria com apoio do IRaMuTeQ e do R.
Em VID02_AI2027 observa-se maior especificidade de termos centrados em ia e humano, com aumento relativo de termos associados a humanidade e a um vocabulário de risco e destino. Essa concentração é coerente com a presença forte das classes 1 e 4, nas quais a inteligência artificial aparece como agente de escalada e o público recorre a marcos culturais para interpretar o colapso. Em termos interpretativos, isso sugere que o subcorpus AI2027 tende a produzir uma conversação mais antropológica e existencial, na qual medo, perda de controle e leitura apocalíptica ou de ameaça sistêmica ganham densidade.
Em VID01_FINCAP, ao contrário, o padrão de especificidades se desloca para léxico econômico social. Aumenta a especificidade de termos como trabalho, capitalismo, renda, empresa, emprego, trabalhador, e fortalecem-se conexões com consumo, dinheiro, pagar e comprar. Esse padrão é coerente com a localização de VID01_FINCAP no lado positivo do Fator 1 e com a presença destacada das classes 2 e 3. A discussão se organiza em torno de mecanismos de mercado, distribuição, consumo e políticas de compensação. A inteligência artificial é compreendida menos como entidade autônoma e mais como força que reorganiza trabalho, renda e a estrutura do capitalismo.
O valor metodológico dessa saída é que ela opera como triangulação interna. A nuvem de palavras descreve o horizonte temático geral. O grafo de similitude revela a arquitetura das associações. CHD e AFC descrevem classes e oposições estruturais. E a especificidade confirma que a diferença entre VID01_FINCAP e VID02_ AI2027 está inscrita em padrões lexicais mensuráveis e consistentes com os enquadramentos de origem. Isso permite formular interpretações mais robustas sobre como o público desloca o sentido conforme o tipo de narrativa midiática.
A leitura conjunta das quatro figuras sugere que a conversação pública analisada se organiza em torno de um núcleo semântico comum, IA, humano, futuro, trabalho, emprego, capitalismo, renda. No entanto, ela-se bifurca em repertórios distintos conforme o enquadramento midiático. VID02_ AI2027 ativa com maior intensidade um imaginário de ameaça existencial e perda de controle, acompanhado por traduções culturais em chave de ficção e referências narrativas que estabilizam o medo por meio de analogias disponíveis. VID01_FINCAP, por sua vez, ativa um repertório de economia política do trabalho, no qual o problema se formula como crise distributiva, queda do consumo, concentração de renda e necessidade de respostas como renda universal.
Esse padrão oferece um resultado central para a discussão posterior. Os comentários não registram apenas posições a favor ou contra uma tecnologia. Eles registram a construção social de futuros possíveis, com afetos públicos, juízos morais e diagnósticos distributivos que variam conforme o enquadramento inicial do conteúdo midiático. Nesse sentido, o corpus funciona como termômetro discursivo situado. Ele não representa automaticamente toda a população, mas permite observar, com evidência empírica, quais repertórios interpretativos se tornam mais disponíveis quando a inteligência artificial deixa de ser percebida como ferramenta abstrata e passa a ser vivida como ameaça material e simbólica.
Discussão
Os achados confirmam que os comentários não funcionam como uma simples caixa de depósito de opiniões individuais, mas como um espaço de recepção ativa no qual o público reescreve o sentido do conteúdo, o negocia e, em certos casos, o confronta. Na perspectiva de Hall, a mensagem midiática apresenta-se como uma proposta de significado, mas a audiência a decodifica a partir de posições sociais e de marcos culturais diferenciados, produzindo leituras dominantes, negociadas ou enfrentadas que ficam inscritas no texto público da plataforma (Hall, 1980). Neste corpus, essa recepção se intensifica porque a inteligência artificial não aparece como tema distante, mas como um problema de sobrevivência material, de continuidade do mundo social e de justiça distributiva, isto é, como um objeto que ativa interpretações moralizadas e afetivamente densas.
Em termos de enquadramento, os resultados permitem sustentar que a conversação se organiza por marcos diferenciados, acionados pelos disparadores midiáticos de cada vídeo. Entman define framing como o processo pelo qual se selecionam e se salientam aspectos de um assunto para definir o problema, atribuir causalidade, emitir uma avaliação moral e sugerir soluções plausíveis (Entman, 1993). Em coerência com essa leitura, a estrutura fatorial e a classificação hierárquica mostram que VID01_FINCAP e VID02_ AI2027 não apenas geram temas distintos, mas arquiteturas de sentido distintas. O primeiro se aproxima de um enquadramento econômico estrutural, com vocabulário de capitalismo, empresa, consumo, renda, pagar, comprar, trabalhador e classe, o que sugere que a inteligência artificial é codificada como reconfiguração do trabalho e crise distributiva. O segundo intensifica um enquadramento prospectivo distópico, com maior densidade de humano, humanidade, destruir, controlar, máquina e consciência, além de uma camada cultural explícita. Isso indica que o enquadramento não apenas orienta o que se comenta, mas também que tipo de futuro se torna imaginável, e quais emoções se tornam socialmente dizíveis.
Essa camada cultural não deve ser lida como ruído, mas como um dispositivo de tradução coletiva. A noção de imaginários sociotécnicos permite compreender por que um documento de prospectiva aciona respostas que parecem roteirizadas, as sociedades não discutem futuros a partir do zero, elas discutem com repertórios prévios, com cenas e metáforas disponíveis, que tornam comunicável o medo e facilitam a atribuição de responsabilidades (Jasanoff & Kim, 2015). Nessa linha, quando o conteúdo propõe escalada rápida, perda de controle e limiares de risco, parte do público encaixa o novo em relatos culturalmente estabilizados. Kirby mostrou que a ficção opera como um laboratório social de futuros, porque fornece protótipos narrativos que permitem antecipar como seria sentir um mundo técnico antes de ele existir plenamente, e, por isso, estrutura linguagens, analogias e emoções no debate público (Kirby, 2010). No corpus, essa operação se expressa como uma economia retórica de comparações e cenas, na qual a discussão deixa de ser apenas técnica e se torna discussão sobre destino.
Um segundo eixo interpretativo é a centralidade do afeto como organizador do público. Papacharissi propõe que, em ambientes conectivos, emergem públicos afetivos, nos quais a emoção não é um resíduo da racionalidade, mas uma infraestrutura de agregação, visibilidade e pertencimento (Papacharissi, 2015). Em coerência com essa ideia, medo, ironia, resignação e raiva distributiva aparecem como clima compartilhado, e não apenas como estilo individual. O grafo de similitude, ao mostrar polos que concentram ameaça existencial e polos que concentram economia moral do trabalho, sugere que a conversação não está resolvendo-se a inteligência artificial é boa ou má, mas gerenciando afetivamente uma transição percebida como assimétrica, rápida e pouco governada.
Esse clima se intensifica pela lógica das plataformas. A sociedade de plataformas, tal como descrita por Van Dijck, Poell e de Waal, implica que infraestruturas privadas mediam valores públicos, distribuem visibilidade e organizam participação por meio de arquiteturas técnicas e incentivos de interação (Van Dijck et al., 2018). Srnicek, ao conceituar o capitalismo de plataformas, acrescenta que essas infraestruturas se articulam com extração de dados e reorganização do trabalho sob formas de intermediação que reconfiguram poder e precariedade (Srnicek, 2016). Nesse marco, o comentário não é um reflexo neutro, mas uma prática situada, condicionada por recomendação, cultura de interação e dinâmicas de engajamento. Por isso, o corpus deve ser lido como observatório de percepção social dentro de um espaço algorítmico, e não como representação estatística da sociedade, uma cautela coerente com as advertências de Boyd e Crawford sobre vieses de participação, desigualdades de visibilidade e riscos de inferências abusivas em pesquisa com dados massivos (Boyd & Crawford, 2012), e com a crítica de Kitchin sobre infraestruturas de dados e poder (Kitchin, 2014).
Um terceiro aporte é mostrar que, embora o debate se inicie em chave laboral, ele-se desloca rapidamente para uma discussão sobre autoridade e controle. Essa transição dialoga com a leitura de Gillespie, para quem os algoritmos operam como mediadores culturais que hierarquizam relevância e moldam as condições da conversação pública (Gillespie, 2014). Quando o objeto de discussão é a automação, o próprio cenário da discussão já é automatizado, e esse cruzamento produz uma leitura em dupla camada, teme-se a tecnologia e, também, a opacidade do ambiente que a distribui, a prioriza e a faz circular. Daí emergirem narrativas de controle, manipulação e destino, porque o problema percebido não se reduz à substituição de tarefas, mas inclui uma sensação de enfraquecimento do controle social sobre decisões técnicas.
Esse deslocamento conecta-se a diagnósticos de economia política dos dados. Zuboff descreve um regime de acumulação baseado na captura e na monetização do comportamento, com efeitos sobre autonomia, dependência e autoridade (Zuboff, 2019). Couldry e Mejias ampliam esse argumento ao propor o colonialismo de dados como lógica extrativa que converte a vida social em recurso, normalizando apropriação e assimetria (Couldry & Mejias, 2019). No corpus, essa crítica torna-se experiência vivida na forma de suspeita moral, quem ganha, quem decide, quem será sacrificado, o que ocorre com a dignidade do trabalho e com a possibilidade de sustentar uma vida mínima. Em consequência, a percepção pública não se limita à empregabilidade, ela-se transforma em juízo sobre justiça distributiva e legitimidade da transição.
Metodologicamente, a triangulação entre CHD, AFC, similitude e especificidades reforça a validade interpretativa do estudo, ao permitir observar regularidades e oposições e, ao mesmo tempo, retornar ao texto por segmentos característicos. IRaMuTeQ é pertinente precisamente porque evita tanto interpretações intuitivas não sistematizadas quanto procedimentos puramente quantitativos desvinculados do sentido discursivo (Camargo & Justo, 2013; Ratinaud, 2009). Além disso, a noção de métodos digitais de Rogers é consistente com o uso de rastros nativos e com procedimentos replicáveis, sem confundir rastro digital com totalidade social (Rogers, 2013). No plano das implicações, a leitura comparativa sugere que a conversação se organiza em torno de duas gramáticas que convivem e disputam sentido, uma gramática do colapso, que narrativiza a ameaça e a torna existencial, e uma gramática da redistribuição, que traduz a automação em crise do salário, do consumo e da reprodução social, e imagina saídas como renda universal, regulação ou intervenção estatal. Esse achado dialoga com cenários de prospectiva institucional, como os do World Economic Forum, que alertam que a aceleração tecnológica,-se não for acompanhada de educação e requalificação, pode ampliar desigualdades e elevar riscos de desorganização laboral, especialmente em economias emergentes (WEF, 2025, p. 9).
Por fim, o estudo reafirma limites que devem permanecer explícitos. A plataforma condiciona participação, visibilidade e estilo discursivo, e o corpus é composto por quem comenta, não por quem apenas observa, e menos ainda pelo conjunto social. A validade da análise, portanto, é cultural e comunicacional, identifica repertórios, afetos e enquadramentos disponíveis na conversação pública digital, e não estima prevalências populacionais. Essa delimitação coincide com a crítica à neutralidade do dado e com a necessidade de descrever mediações de captura e circulação (Boyd & Crawford, 2012; Kitchin, 2014). Em conjunto, a discussão permite sustentar que os comentários operam como termômetro discursivo de uma transição tecnológica percebida como rápida e assimétrica, não porque meçam uma verdade social total, mas porque revelam como o futuro se torna dizível em linguagem comum, com marcos interpretativos, emoções e juízos morais modulados pelo enquadramento midiático.
Conclusões
Este artigo oferece evidência empírica de que a conversação pública digital sobre inteligência artificial, quando acionada por conteúdos jornalísticos de alta circulação, tende a codificar a tecnologia como problema de sobrevivência material e de justiça distributiva, mais do que como promessa técnica, e que essa codificação se organiza em enquadramentos diferenciados conforme o estímulo midiático. Em termos analíticos, a principal contribuição consiste em demonstrar, com apoio do IRaMuTeQ, como emergem duas gramáticas dominantes, colapso e redistribuição, que estruturam o debate e orientam a imaginação social sobre o futuro do trabalho.
Do ponto de vista comunicacional, os resultados sugerem que o debate não se limita a avaliar tecnologias. Ele produz enquadramentos interpretativos e climas afetivos que agregam e ordenam a conversação pública. Nesse sentido, a discussão sobre inteligência artificial exige mediações educativas e comunicacionais capazes de lidar com enquadramentos, emoções e desigualdades, e não apenas com divulgação técnica (Hall, 1980; Entman, 1993; Papacharissi, 2015). Além disso, o fato de essas percepções se expressarem dentro de infraestruturas de plataforma reforça que governança tecnológica também é governança de condições de visibilidade, participação e poder mediadas por sistemas privados, o que incide diretamente na legitimidade social de qualquer transição (Srnicek, 2016; Van Dijck et al., 2018). O achado de uma dupla camada de inquietação, sobre os efeitos da automação no trabalho e sobre a opacidade algorítmica que ordena o que circula, sugere que as controvérsias em torno da inteligência artificial não são apenas técnicas, mas também políticas, morais e comunicacionais, articuladas em ambientes cuja arquitetura premia certas formas de atenção e reduz a exposição ao dissenso (Gillespie, 2014; Zuboff, 2019; Couldry & Mejias, 2019).
O estudo apresenta limites claros. Ele-se baseia em rastros nativos de uma plataforma, com vieses de participação e de visibilidade próprios do ambiente, e, por isso, não pretende representar a população em geral. Seu alcance é descritivo e interpretativo, voltado a repertórios discursivos disponíveis na conversação pública conectiva, sob condições algorítmicas específicas (Boyd & Crawford, 2012; Kitchin, 2014; Rogers, 2013). Pesquisas futuras podem ampliar o desenho por meio de comparação com outras plataformas, janelas temporais mais longas, estratificação por eventos e integração com leitura qualitativa aprofundada de segmentos característicos, de modo a compreender com maior precisão como esses enquadramentos se estabilizam, circulam e são disputados, e como se conectam a políticas de educação, requalificação e governança tecnológica. Nesse ponto, o diálogo com cenários institucionais é especialmente produtivo, porque diferentes organismos já indicam que a aceleração tecnológica, sem mecanismos robustos de formação e recapacitação, pode intensificar desigualdades e elevar riscos de desorganização laboral, particularmente em economias emergentes. Essa convergência ajuda a contextualizar os temores observados no corpus não como anomalia discursiva, mas como expressão situada de um problema reconhecido na agenda global.
Referências bibliográficas
BBC News Brasil. (2025a, August 10). É assim que a inteligência artificial pode destruir a humanidade [Video]. YouTube. https://www.youtube.com/watch?v=oTptR7O0KNI
BBC News Brasil. (2025b, December 18). A inteligência artificial pode significar a destruição do capitalismo como conhecemos hoje [Video]. YouTube. https://www.youtube.com/watch?v=gN9QAFG2A2w
Boyd, d., & Crawford, K. (2012). Critical questions for big data. Information, Communication & Society, 15(5), 662–679. https://doi.org/10.1080/1369118X.2012.678878
Busón, C., Pérez Mendoza, K., & Pineda Arroyo, M. C. (2023). El trabajo y la tecnología en la cuarta revolución industrial. Un reto para la educación y la economía en un mundo en post pandemia. Entretextos, 17(32), 285–306.
Busón, C., Carbalí, A., Pérez Mendoza, K., & Díez Rodríguez, Á. (2022). Análisis de los comentarios a un pronunciamiento presidencial sobre el COVID-19 en Brasil, realizado el 23 de marzo de 2021. Ámbitos. Revista Internacional de Comunicación, (57), 97–118. https://doi.org/10.12795/Ambitos.2022.i57.08
Camargo, B. V., & Justo, A. M. (2013). IRaMuTeQ. Um software gratuito para análise de dados textuais. Temas em Psicologia, 21(2), 513–518. https://www.redalyc.org/pdf/5137/513751532016.pdf
Couldry, N., & Mejias, U. A. (2019). The costs of connection. How data is colonizing human life and appropriating it for capitalism. Stanford University Press. https://doi.org/10.1515/9781503609754
Criddle, C. (2025, September 5). Geoffrey Hinton. AI will make a few people much richer and most people poorer. Financial Times. https://www.ft.com/content/31feb335-4945-475e-baaa-3b880d9cf8ce
Dick, P. K. (1953). Second variety. Space Science Fiction, 2(3), 17–35.
Entman, R. M. (1993). Framing. Toward clarification of a fractured paradigm. Journal of Communication, 43(4), 51–58. https://doi.org/10.1111/j.1460-2466.1993.tb01304.x
Gillespie, T. (2014). The relevance of algorithms. In T. Gillespie, P. J. Boczkowski, & K. A. Foot (Eds.), Media technologies. Essays on communication, materiality, and society (pp. 167–193). MIT Press. https://doi.org/10.7551/mitpress/9780262525374.001.0001
Gmyrek, P., Berg, J., Bescond, D., et al. (2025). Generative AI and jobs. A refined global index of occupational exposure. International Labour Organization. https://www.ilo.org/publications/generative-ai-and-jobs-refined-global-index-occupational-exposure https://doi.org/10.54394/HETP0387
Hall, S. (1980). Encoding and decoding. In S. Hall, D. Hobson, A. Lowe, & P. Willis (Eds.), Culture, media, language. Working papers in cultural studies, 1972–1979 (pp. 128–138). Hutchinson. https://pages.mtu.edu/~jdslack/readings/CSReadings/Hall_Encoding-n-Decoding.pdf
Jasanoff, S., & Kim, S. H. (Eds.). (2015). Dreamscapes of modernity. Sociotechnical imaginaries and the fabrication of power. University of Chicago Press. https://press.uchicago.edu/ucp/books/book/chicago/D/bo20836025.html
Kirby, D. A. (2010). The future is now. Diegetic prototypes and the role of popular films in generating real-world technological development. Social Studies of Science, 40(1), 41–70. https://doi.org/10.1177/0306312709338325
Kitchin, R. (2014). The data revolution. Big data, open data, data infrastructures and their consequences. SAGE. https://uk.sagepub.com/en-gb/eur/the-data-revolution/book235104
Kokotajlo, D., Alexander, S., Larsen, T., Lifland, E., & Dean, R. (2025). AI 2027. AI Futures Project. https://ai-2027.com/
Kubrick, S. (Director). (1968). 2001. A space odyssey [Film]. Metro-Goldwyn-Mayer. https://www.imdb.com/title/tt0062622/
Lem, S. (1981). Golem XIV. In Wielkość urojona. Wydawnictwo Literackie. https://culture.pl/en/work/golem-xiv-stanislaw-lem
OECD - Organisation for Economic Co-operation and Development. (2024). OECD employment outlook 2024. OECD Publishing. https://www.oecd.org/en/publications/oecd-employment-outlook-2024_9b8d0dc7-en.html
Papacharissi, Z. (2015). Affective publics. Sentiment, technology, and politics. Oxford University Press. https://doi.org/10.1093/acprof:oso/9780199999736.001.0001
Pérez Mendoza, K., & Busón Buesa, C. (2021). La percepción de la falta de agua en las comunidades Wayuu en La Guajira, Colombia. Una propuesta para el uso de las redes sociales como herramienta de análisis de desarrollo. Desenvolvimento em Questão, 19(57), 278–290. https://doi.org/10.21527/2237-6453.2021.57.12107
Ratinaud, P. (2009). IRaMuTeQ. Interface de R pour les analyses multidimensionnelles de textes et de questionnaires [Software]. http://www.iramuteq.org
Reuters. (2024, July 31). AI could eliminate up to 5% of jobs in Latin America, study finds. Reuters. https://www.reuters.com/world/americas/ai-could-eliminate-up-5-jobs-latin-america-study-finds-2024-07-31/
Rogers, R. (2013). Digital methods. MIT Press. https://mitpress.mit.edu/9780262519222/digital-methods/
Srnicek, N. (2016). Platform capitalism. Polity Press.
Van Dijck, J., Poell, T., & de Waal, M. (2018). The platform society. Public values in a connective world. Oxford University Press.
Von Foerster, H., Mora, P. M., & Amiot, L. W. (1960). Doomsday Friday, 13 November, A.D. 2026. Science, 132(3436), 1291–1295. https://doi.org/10.1126/science.132.3436.1291
WEF - World Economic Forum. (2025). Four futures for the new economy. Geoeconomics and technology in 2030. World Economic Forum. https://www.weforum.org
Zuboff, S. (2019). The age of surveillance capitalism. The fight for a human future at the new frontier of power. PublicAffairs.
Biodata
Carlos Busón Buesa: Profesor visitante sénior en el Programa de Pós Graduação em Comunicação de la Universidade Federal de Mato Grosso do Sul, en Campo Grande, Mato Grosso do Sul, Brasil. Doctor en Comunicación y Educación en Entornos Digitales por la UNED (2011). Máster en Comunicación y Educación en Redes por la UNED (2010), cuenta con DEA en Geografía Humana y Económica por la UNED (2003 a 2007). Licenciado en Ciencias Geológicas, Universidad Complutense de Madrid (1990). Posdoctor en Desarrollo Territorial y Sistemas Productivos, Universidade Estadual de Mato Grosso do Sul. Su investigación se centra en comunicación digital, educación, cultura contemporánea y transformaciones sociotécnicas. Integra humanidades digitales con análisis de datos, minería de texto y metodologías reproducibles. Desarrolla estudios sobre percepción social de la inteligencia artificial y conversación pública en plataformas. Trabaja bajo principios de ciencia abierta, con disponibilidad de materiales y trazabilidad metodológica cuando el proyecto lo permite. Ha participado en iniciativas vinculadas a laboratorio y proyectos de humanidades digitales en el contexto universitario brasileño. Colabora en agendas de digitalización y patrimonio cultural con enfoque pedagógico y comunitario en América Latina como consultor para la OEI. Impulsa propuestas de innovación educativa orientadas al diálogo, al pensamiento crítico y al aprendizaje situado. Su producción académica se refleja en publicaciones indexadas y en su perfil público de citación. Sus intereses incluyen TIC, educomunicación, territorio, identidad cultural, análisis de discursos digitales y una mirada humanista sobre los desafíos del presente digital.